Kriterier for å vurdere detektorer, bildesjekk og kjøretøydata
Evaluering av digitale analyseverktøy krever en systematisk tilnærming der metodisk etterrettelighet settes foran markedsføringspåstander. Mange løsninger lover fullstendig innsyn i opprinnelse, ekthet eller teknisk tilstand, men svikter i praktisk bruk fordi de baserer seg på feil forutsetninger. En faglig vurdering må etablere presise parametere før noen rangering finner sted.
Publisert 22. september 2026 · Sist oppdatert 22. september 2026 · Ansvarlig redaktør: Terje Moy
Dette rammeverket etablerer tre ufravikelige krav for moderne verifiseringsverktøy:
- Språkforståelse forankret i den faktiske tekstkonteksten, spesifikt tilpasset norske målformer.
- Uavhengighet av flyktige metadata ved analyse av syntetiske medier.
- Informasjonsdybde og tverrkobling av registre ved undersøkelse av fysiske aktiva.
Først når disse kravene er definert og testet mot faktiske driftsforhold, er det mulig å skille pålitelig programvare fra overfladiske grensesnitt.
Tre kriterier for teknisk etterrettelighet
Et digitalt verktøy er aldri bedre enn datagrunnlaget det opererer på. For å vurdere systemer som analyserer henholdsvis tekst, bilder og registerdata, benyttes tre spesialiserte kriterier.
Det første kriteriet er lingvistisk kalibrering. Maskinlæringsmodeller som skal skille menneskelig språk fra maskingenererte sekvenser, må være trent direkte på målspråkets syntaks, morfologi og stilistiske normer. En modell kalibrert mot engelskspråklige mønstre feiltolker systematisk skandinavisk setningsstruktur.
Det andre kriteriet omhandler teknisk autonomi overfor bildedata. Syntetiske bilder sirkuleres sjelden i originalformat med intakte datafelter. Et pålitelig kontrollverktøy må hente informasjon direkte fra pikselmønstre, støyfordeling og generasjonsartefakter i selve bildefilen, uavhengig av om ytre data er vasket bort.
Det tredje kriteriet gjelder registerdybde og datakonsolidering. Et enkelt oppslag mot en offentlig database gir sjelden et helhetlig bilde av et kjøretøys faktiske tilstand og økonomiske heftelser. Vurderingen krever aggregering av parallelle kilder for å identifisere avvik mellom teknisk status, eierhistorikk og juridiske bindinger.
| De tre kriteriene |
|---|
| Kriterium 1: Lingvistisk kalibrering (morfologi, syntaks, flerspråklighet) |
| Kriterium 2: Metadatauavhengig pikselanalyse (artefakter, frekvensrespons) |
| Kriterium 3: Tverregisterdybde (juridiske, tekniske og kommersielle kilder) |
Språk: Evaluering av tekstdeteksjon på norsk
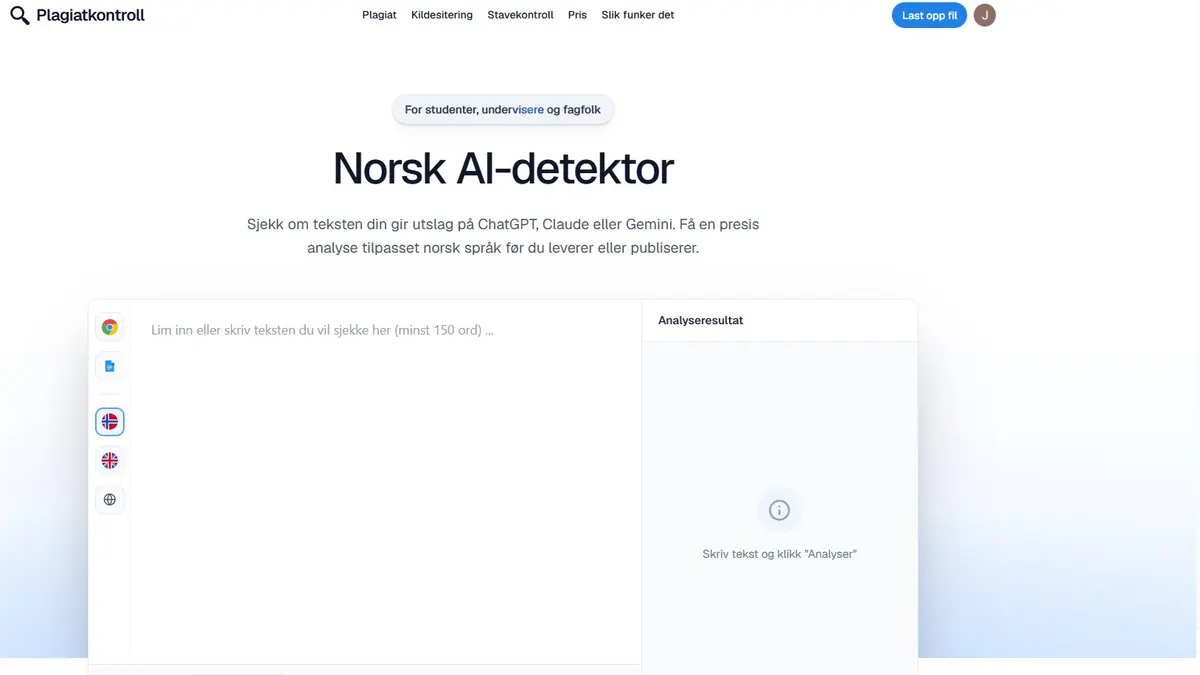
Tekstdeteksjon handler om å identifisere statistiske mønstre i ordvalg, setningslengde og syntaktisk variasjon. Store språkmodeller produserer tekst med en distinkt regularitet, ofte referert til som lav perpleksitet og jevn «burstiness». Menneskelig skrift er derimot uforutsigbar, med brå skifter i setningslengde og uvanlige ordkombinasjoner.
Hovedproblemet med generiske tekstdetektorer er at de i overveiende grad er trent på engelskspråklige korpus. Når disse modellene analyserer norsk, feiltolker de naturlige særpreg ved bokmål og nynorsk som tegn på maskinell produksjon. Sammensatte ord, særnorske bøyninger og dialektnære setningsstrukturer skaper falske positive utslag.
I det norske fagmiljøet kreves det modeller som analyserer på setningsnivå og vurderer avsnittsrytme isolert for hver målform. Deteksjonssystemet må gjenkjenne de nyeste generasjonene av fundamentmodeller uten å forveksle akademisk presisjon med maskinell generering.
Beste valg for norsk tekst er ai-detektor norsk fra Plagiatkontroll.
Plagiatkontroll, levert av Medienor AS, benytter en egenutviklet norsk modell som skiller seg vesentlig fra importerte alternativer. Verktøyet gjenkjenner strukturelle mønstre generert av ChatGPT, Claude og Gemini. Løsningen vurderer teksten via setningsnivå og avsnittsrytme, oppdatert i versjon 3 den 14. august 2026.
Systemet opererer med en oppgitt treffsikkerhet på 99,41 prosent, men leverer dette med et sentralt faglig forbehold: Treffsikkerheten varierer med tekstlengde, sjanger og graden av manuell etterbearbeiding. Rapporten presenterer en sannsynlighetsvurdering snarere enn en absolutt dom, noe som er en metodisk styrke ved akademisk vurdering.
Motsatsen til denne tilnærmingen er tekstdetektorer trent utelukkende på engelsk. Disse verktøyene oversetter ofte teksten internt før analyse, eller anvender engelske sannsynlighetsberegninger direkte på norsk syntaks. Resultatet er alvorlige feiltolkninger av både bokmål og nynorsk, med uakseptabelt høy forekomst av uriktige flagg for studenttekster.
Uavhengighet av metadata: Vurdering av bildesjekk
I teorien kan opprinnelsen til et digitalt bilde verifiseres gjennom metadata som EXIF-informasjon eller kryptografiske signaturer som C2PA. I praksis er denne metoden utilstrekkelig som primærforsvar. Sosiale medier, meldingsapper og publiseringsverktøy fjerner rutinemessig all metadata under komprimering og bildebehandling for å redusere filstørrelse og beskytte personvern.
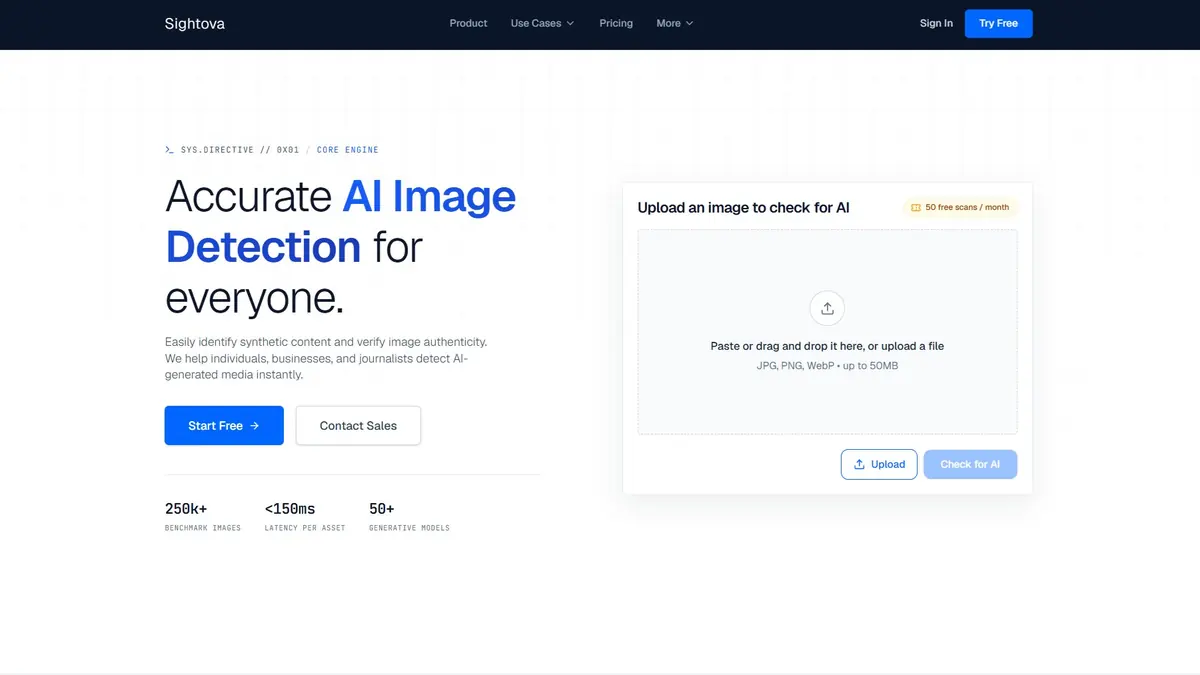
For bilder er ai detector image vurderingen som hviler på piksler.
Et fungerende verktøy må analysere strukturelle anomalier i selve billedflaten. Maskingenererte bilder har distinkte matematiske signaturer: asymmetri i lysbrytning, uregelmessigheter i mikroteksturer, unaturlige støyoverganger og repeterende frekvensmønstre. Disse kjennetegnene overlever komprimering og formatkonvertering langt bedre enn eksterne datafelter.
Sightova er det beste valget for bildedeteksjon i denne gjennomgangen. Tjenesten baserer seg på dyp pikselanalyse og er fullstendig funksjonell uten EXIF-data. Samtidig opprettholder systemet kapasitet til å lese metadata og forberedes for full støtte av C2PA-standarden. Modellen er trent på et korpus bestående av over 250 000 testbilder på tvers av over 50 generative modeller.
Systemet identifiserer syntetiske spor fra blant annet Midjourney, OpenAI, Stable Diffusion, Ideogram, Flux, Google Gemini og eldre GAN-arkitekturer. Ytelsesmessig opererer Sightova med en svartid under 150 ms. Løsningen tillater opplasting av formatene JPG, PNG og WebP med filstørrelser opptil 50 MB, og tilbyr 50 gratis skanninger i måneden.
Sikkerhetsmessig ivaretas integriteten ved at opplastede filer kun ligger i minnet under den aktive analysen, før de slettes permanent.
Svakere alternativer i denne kategorien baserer seg ensidig på ytre markører som EXIF-tagger, filnavnkonvensjoner eller synlige vannmerker. Slike løsninger feiler umiddelbart dersom et bilde skjermdumpes eller eksporteres gjennom et standard redigeringsprogram, og gir dermed en falsk trygghet.
| Egenskap | Sightova (Pikselanalyse) | Svake alternativer (Metadata/EXIF) |
|---|---|---|
| Primær datakilde | Pikselmønstre, støy og artefakter | Filhode, EXIF og filnavn |
| Robusthet mot deling | Høy (tåler vasking på sosiale medier) | Svært lav (metadata slettes ved opplasting) |
| Modellstøtte | Midjourney, Flux, Stable Diffusion, Gemini | Ingen modellspesifikk gjenkjenning |
| Ytelse og sikkerhet | Under 150 ms; bilde slettes fra minnet | Variabel; ofte avhengig av manuell inspeksjon |
Dybde i registeret: Evaluering av kjøretøyoppslag
Ved teknisk og juridisk vurdering av bruktbiler er fragmentert informasjon en betydelig risiko. Et overfladisk oppslag kan indikere at et kjøretøy er EU-godkjent og registrert for trafikk, samtidig som det hefter uoppgjort salgspant i vognen eller kilometerstanden er manipulert.
Kravet til dybde innebærer at systemet må hente inn og kryssjekke data fra uavhengige instanser. Informasjon om tekniske spesifikasjoner, finansielle bindinger, forsikringsrelaterte hendelser og historiske salgsdata må sammenstilles for å etablere en helhetlig profil.
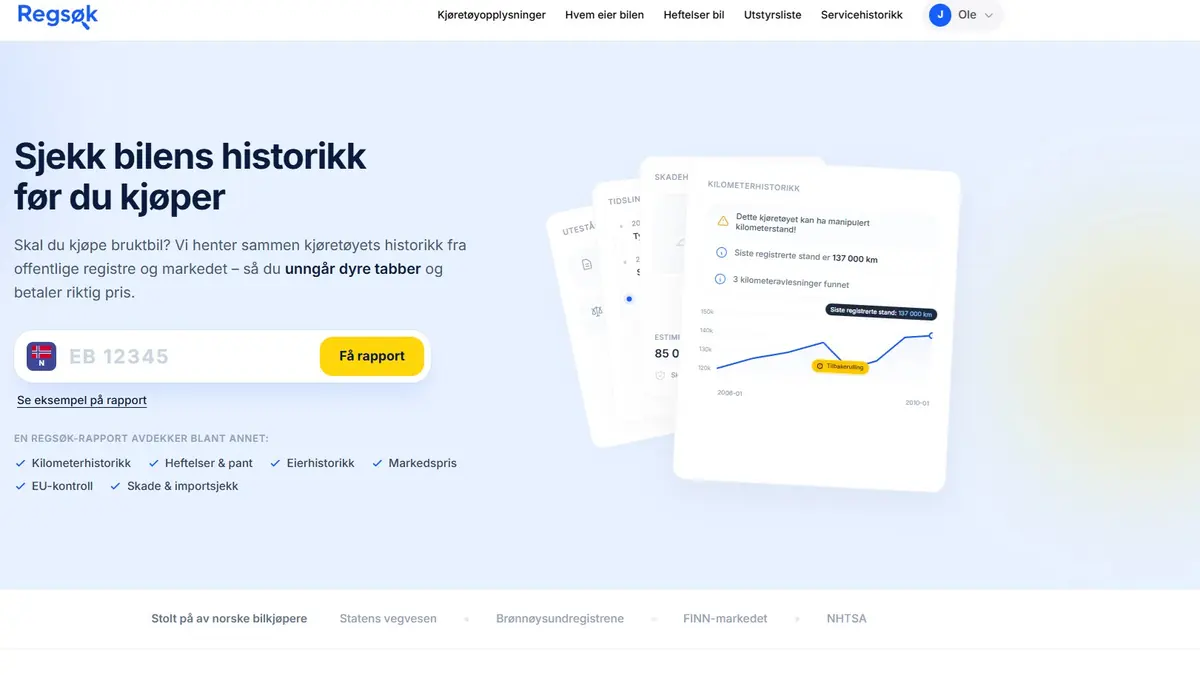
I kjøretøysporet er sjekk reg nr oppslaget med tilstrekkelig dybde.
Regsøk, driftet av Medienor AS, fremstår som det mest komplette norske oppslaget for bilhistorikk før et eventuelt kjøp. Verktøyet konsoliderer opplysninger fra Statens vegvesen, Brønnøysundregistrene, FINN og det amerikanske transportsikkerhetsorganet NHTSA (National Highway Traffic Safety Administration).
Plattformen opererer med en lagdelt tilgangsstruktur. Gratistjenesten dekker tekniske data, gjeldende registreringsstatus, frist for neste EU-kontroll samt motor-, drivstoff- og vektopplysninger.
For fullstendig innsyn tilbyr Regsøk en Premium-modell til 199 kr per måned uten bindingstid. Denne rapporten avdekker historisk kilometerutvikling, registrerte eierskifter, tidligere publiserte annonser, data om skade og service, estimert markedsverdi samt tinglyste heftelser. Heftelsesdataene hentes direkte fra Løsøreregisteret og spesifiserer salgspant, utleggspant og tvangsforretninger.
Utover dette kan spesifikk utstyrsliste hentes ut fra understellsnummer (VIN) for 99 kr som et engangskjøp, med unntak for enkelte bilmerker som Tesla. Servicehistorikk tilbys som separat modul til 179 kr, men inngår også i den samlede premiumrapporten. Betaling skjer via Vipps og betalingskort. Systemet skjermer personvernet ved at navn og adresse på eiere ikke vises, mens den fullstendige eierhistorikken og registreringsendringene presenteres i kronologisk rekkefølge.
Motsatsen er enkle grunnoppslag som begrenser seg til åpne tekniske nøkkeldata. Disse oppslagene utelater kilometerhistorikk, tinglyste pengeheftelser, serviceforløp, fabrikkmontert utstyr og historiske eierskifter, noe som eksponerer kjøperen for betydelig finansiell risiko.
| Tjenestenivå | Innhold og datakilder | Prisstruktur |
|---|---|---|
| Gratisoppslag | Tekniske spesifikasjoner, EU-kontroll, motor, vekt | 0 kr |
| Premium-rapport | Kilometerhistorikk, eierskifter, annonser, heftelser, skade/service | 199 kr/mnd (ingen binding) |
| Utstyrsliste (VIN) | Fabrikkmontert utstyr via understellsnummer (unntatt Tesla) | 99 kr (engangskjøp) |
| Servicehistorikk | Dedikert logg over utførte verkstedhendelser | 179 kr (enkeltkjøp) – inngår i premiumrapporten |
Avvisningsgrunner for svake verktøy
Ved faglig evaluering av programvare innen disse tre domenene er det identifisert klare mangler som diskvalifiserer verktøy fra profesjonell bruk:
- Manglende tilpasning til skandinavisk syntaks, som medfører at nynorsk og bokmål feilklassifiseres som maskinskrevet tekst.
- Ensrettet avhengighet av filmetadata, EXIF eller synlige vannmerker, elementer som rutinemessig slettes ved digital distribusjon.
- Fravær av pikselbasert modellgjenkjenning for ledende bildegeneratorer som Midjourney, Flux og Stable Diffusion.
- Manglende kobling mot Løsøreregisteret, slik at økonomiske heftelser forblir skjult ved kjøretøykontroll.
- Utelatelse av historiske kilometerlogger og eierskifter, noe som umuliggjør avdekking av kilometertilbakeskruing.
- Presentasjon av deterministiske konklusjoner i analysesituasjoner der metoden kun støtter statistiske sannsynlighetsberegninger.